سیستم مناسب اجرای هوش مصنوعی لوکال؛ راهنمای انتخاب کامپیوتر
برای انتخاب سیستم مناسب اجرای هوش مصنوعی لوکال، ابتدا باید مشخص کنید چه مدلی را برای چه کاری میخواهید اجرا کنید. نیاز سختافزاری یک دستیار متنی سبک با ابزار تولید تصویر، ساخت ویدئو یا آموزش مدل یکسان نیست. حتی دو نسخه از یک مدل زبانی، با کوانتایز و طول کانتکست متفاوت، میتوانند مصرف حافظه متفاوتی داشته باشند.
اگر قصد خرید کیس هوش مصنوعی دارید، بهتر است مدل هدف، ظرفیت حافظه و سرعت موردانتظارتان را پیش از انتخاب قطعات تعیین کنید. در این راهنما، مسیر انتخاب کامپیوتر مناسب هوش مصنوعی لوکال را از بررسی سیستم فعلی تا پیشنهاد ترکیب قطعات توضیح میدهیم؛ تمرکز اصلی نیز اجرای مدلهای آماده روی کامپیوتر شخصی است.
❞ خلاصه جواب:
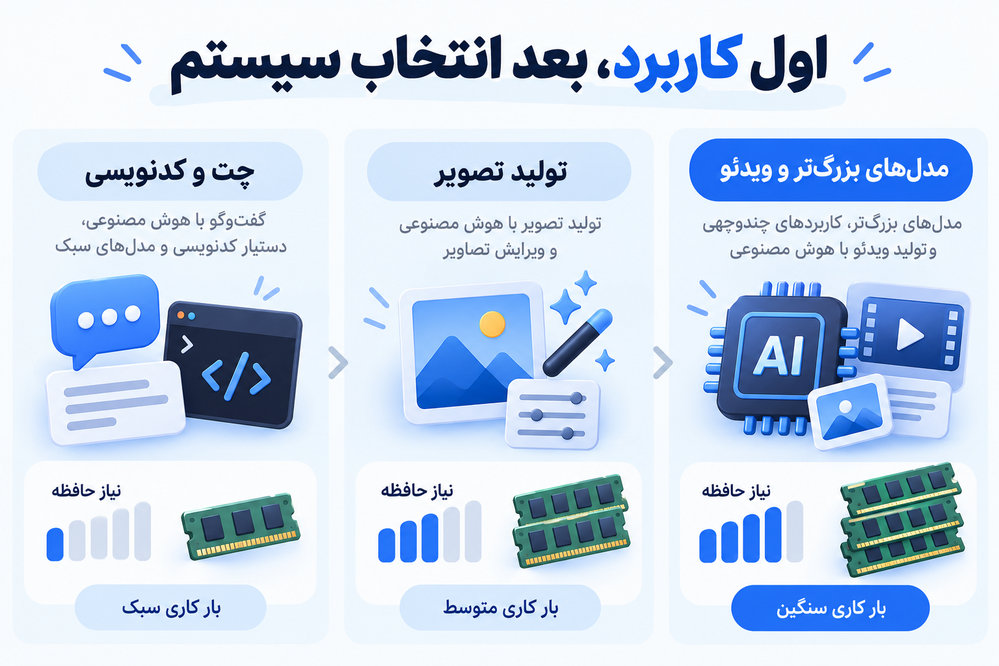
برای انتخاب سیستم مناسب اجرای هوش مصنوعی لوکال، اول مدل و کاربردتان را مشخص کنید. برای شروع با بعضی مدلهای متنی کوچک، سیستم دارای ۱۶ گیگابایت رم و حتی اجرای بدون گرافیک مجزا قابل بررسی است؛ اما برای خرید یک سیستم روزمره، ۳۲ گیگابایت رم، SSD یکترابایتی و کارت گرافیک سازگار با ۱۲ تا ۱۶ گیگابایت VRAM نقطه شروع متعادلتری است. مدلهای بزرگتر، تولید تصویر و ویدئو به بررسی جداگانه نیاز دارند. پیش از خرید، ظرفیت حافظه را با نسخه دقیق مدل، کوانتایز و طول کانتکست تطبیق دهید؛ صرفاً جدیدبودن پردازنده یا عنوان «AI PC» کافی نیست.
سیستم مورد نیاز هوش مصنوعی لوکال چقدر است؟
پاسخ به این پرسش با تفاوت «اجراشدن» و «استفاده راحت» روشن میشود. ممکن است مدلی روی CPU اجرا شود، اما زمان انتظار برای کار روزانه شما مناسب نباشد. از طرف دیگر، برای امتحانکردن یک مدل کوچک، همیشه به خرید گرانترین کارت گرافیک نیاز ندارید.
جدول زیر پیشنهاد اولیه برای برنامهریزی خرید است؛ حداقل رسمی یا نتیجه بنچمارک این سیستمها نیست. ردیفهای متنی با فرض استفاده یک نفر، مدل کوانتایزشده و کانتکست نسبتاً کوتاه در حدود ۴ تا ۸ هزار توکن نوشته شدهاند.
| کاربرد | رم پیشنهادی سیستم | نقطه شروع بررسی GPU | ذخیرهسازی پیشنهادی | محدودیت مهم |
|---|---|---|---|---|
| آشنایی و چت با مدلهای کوچک ۱ تا ۴ میلیارد پارامتری | ۱۶ گیگابایت | اجرای CPU یا گرافیک سازگار، بسته به ابزار | SSD با فضای آزاد کافی برای مدل | سرعت CPU باید عملاً سنجیده شود |
| چت و کدنویسی با برخی مدلهای ۷ تا ۸ میلیارد پارامتری با کوانتایز ۴ بیت | ۳۲ گیگابایت | ۸ گیگابایت قابل بررسی؛ ۱۲ تا ۱۶ گیگابایت برای خرید منعطفتر | SSD یکترابایتی | افزایش کانتکست، حافظه بیشتری میخواهد |
| برخی مدلهای حدود ۱۴ میلیارد پارامتری با کوانتایز ۴ بیت | ۳۲ تا ۶۴ گیگابایت | ۱۶ گیگابایت برای شروع بررسی | SSD یک تا دو ترابایت | ظرفیت دقیق به مدل و تنظیمات بستگی دارد |
| برخی مدلهای حدود ۳۲ میلیارد پارامتری با کوانتایز ۴ بیت | ۶۴ گیگابایت یا بیشتر | ۲۴ تا ۳۲ گیگابایت، پس از محاسبه حافظه | SSD دوترابایتی | ۲۴ گیگابایت برای همه کانتکستها کافی نیست |
| تولید تصویر | ۳۲ تا ۶۴ گیگابایت | ۱۲ تا ۱۶ گیگابایت، با بررسی گردش کار مشخص | SSD یک تا دو ترابایت | مدل، رزولوشن و افزونهها تعیینکنندهاند |
| تولید ویدئو و پردازشهای سنگین | بر اساس مدل و گردش کار | انتخاب بر اساس نیاز همان مدل | متناسب با مدلها و خروجیها | توصیه یک مشخصات ثابت قابل اتکا نیست |
برای درک فاصله اندازه مدلها، فایل رسمی Qwen3-8B با کوانتایز Q4_K_M حدود ۵٫۰۳ گیگابایت است. همین نوع کوانتایز در Qwen3-14B حدود ۹ و در Qwen3-32B حدود ۱۹٫۸ گیگابایت حجم دارد. این اعداد فقط حجم فایل هستند و مصرف نهایی حافظه را نشان نمیدهند.
اجرای AI لوکال چیست و برای چه کارهایی مناسب است؟
اجرای لوکال یعنی پردازش مدل انتخابی روی سختافزار خودتان انجام شود. میتوانید از آن برای نوشتن و خلاصهسازی متن، کمک به کدنویسی، جستوجو در اسناد، تبدیل گفتار به متن یا تولید تصویر استفاده کنید؛ البته به شرط انتخاب مدل و نرمافزار مناسب همان کار.
برای نمونه، مستندات LM Studio توضیح میدهند که پس از دریافت مدل و اجزای موردنیاز، گفتوگو و پردازش محلی اسناد میتواند بدون اینترنت انجام شود. جستوجو و دانلود مدل جدید همچنان به اتصال نیاز دارد.
تفاوت اجرای مدل آماده با فاینتیون و آموزش
در اجرای مدل آماده یا Inference، از مدل موجود خروجی میگیرید. در فاینتیون، پارامترهای مدل یا بخشهایی از آن با داده جدید تنظیم میشوند. آموزش از صفر نیز فرایند دیگری با نیاز محاسباتی و دادهای بسیار متفاوت است.
بنابراین، سیستمی که یک مدل را برای چت اجرا میکند، الزاماً برای آموزش یا فاینتیون همان مدل مناسب نیست. مشخصات این مقاله را نباید بهعنوان نیاز سختافزاری آموزش تعمیم داد.
انتخاب مدل برای متن، اسناد، تصویر و صوت
برای دستیار متنی، کیفیت پاسخ و سرعت اهمیت دارد. در پرسشوپاسخ روی اسناد یا RAG، استخراج متن، مدل embedding و نمایه اسناد هم بخشی از کار هستند. معمولاً همه اسناد یکجا وارد کانتکست نمیشوند؛ قطعات مرتبط بازیابی میشوند.
در تولید تصویر، اجزای بیشتری از گردش کار روی حافظه اثر میگذارند. برای صوت نیز مدل، طول فایل و نیاز به پردازش زنده را مشخص کنید. خرید سیستم باید بر اساس مجموع همین اجزا انجام شود.
چه عواملی مصرف حافظه مدل را تغییر میدهند؟
اندازه مدل و کوانتایز
برچسبی مانند 8B به حدود تعداد پارامترها اشاره دارد. برای تخمین بسیار اولیه وزنها، تعداد پارامترها را در تعداد بیت ضرب و بر ۸ تقسیم میکنیم. مثلاً ۸ میلیارد پارامتر با ذخیرهسازی ۴ بیت، از نظر محاسبه ساده حدود ۴ میلیارد بایت میشود؛ اما فرمت، ضرایب کوانتایز و ذخیره برخی بخشها با دقت بالاتر به آن اضافه میشوند.
کوانتایز، نمایش وزنها را کمحجمتر میکند. نتیجه میتواند کاهش مصرف حافظه باشد، اما تأثیر آن بر کیفیت و سرعت به مدل، روش کوانتایز و سختافزار بستگی دارد. عدد بیت پایینتر را معادل کیفیت برابر یا سرعت بیشتر قطعی ندانید. قالب GGUF نیز ظرف نگهداری مدل و اطلاعات آن است؛ نام این قالب بهتنهایی دقت یا مصرف حافظه را مشخص نمیکند.
طول کانتکست و KV Cache
کانتکست مقدار متنی است که مدل در یک مرحله در اختیار دارد؛ دستور، تاریخچه و بخشهایی از فایل ورودی در این ظرفیت سهم دارند. در بسیاری از مدلهای زبانی، KV Cache برای نگهداری اطلاعات محاسباتی توکنها استفاده میشود.
بالابردن کانتکست میتواند مصرف حافظه را افزایش دهد. به همین دلیل، نتیجه اجرای یک پرسش کوتاه را به بررسی فایل طولانی یا یک مخزن کد بزرگ تعمیم ندهید.
تعداد کاربران و نوع ورودی
اجرای همزمان درخواستها و نگهداری چند مدل، ظرفیت بیشتری میخواهد. Ollama نیز افزایش تخصیص حافظه با پردازش موازی را توضیح داده است. در مدلهای تصویری و ویدئویی، رزولوشن، تعداد خروجی و تعداد فریمها را هم باید در آزمون ثابت نگه داشت.
کارت گرافیک مناسب AI لوکال را چگونه انتخاب کنیم؟
برای اجرای شتابگرفته روی GPU، ابتدا بررسی کنید مدل و حافظه کاری آن با ظرفیت در دسترس سازگار باشند. سپس توان پردازشی، پهنای باند حافظه و عملکرد واقعی در ابزار انتخابی را مقایسه کنید. ظرفیت VRAM بهتنهایی تعیینکننده سرعت نیست، اما کمبود آن میتواند انتخاب مدل و تنظیمات را محدود کند.
سازگاری NVIDIA، AMD و Intel
پیش از خرید سیستم مناسب ai لوکال، نام دقیق کارت، سیستمعامل، نسخه درایور و مسیر شتابدهی ابزار را بررسی کنید. پشتیبانی CUDA، ROCm، Vulkan، SYCL یا Metal در ابزارهای مختلف یکسان نیست. مستندات Ollama و llama.cpp مسیرهای سختافزاری پشتیبانیشده را جداگانه مشخص میکنند.
اگر میان برندها تردید دارید، مقایسه Nvidia یا AMD برای هوش مصنوعی را با توجه به نرمافزار و مدل هدف دنبال کنید. انتخاب مناسب یک ابزار لزوماً انتخاب مناسب تمام گردشهای کاری نیست.
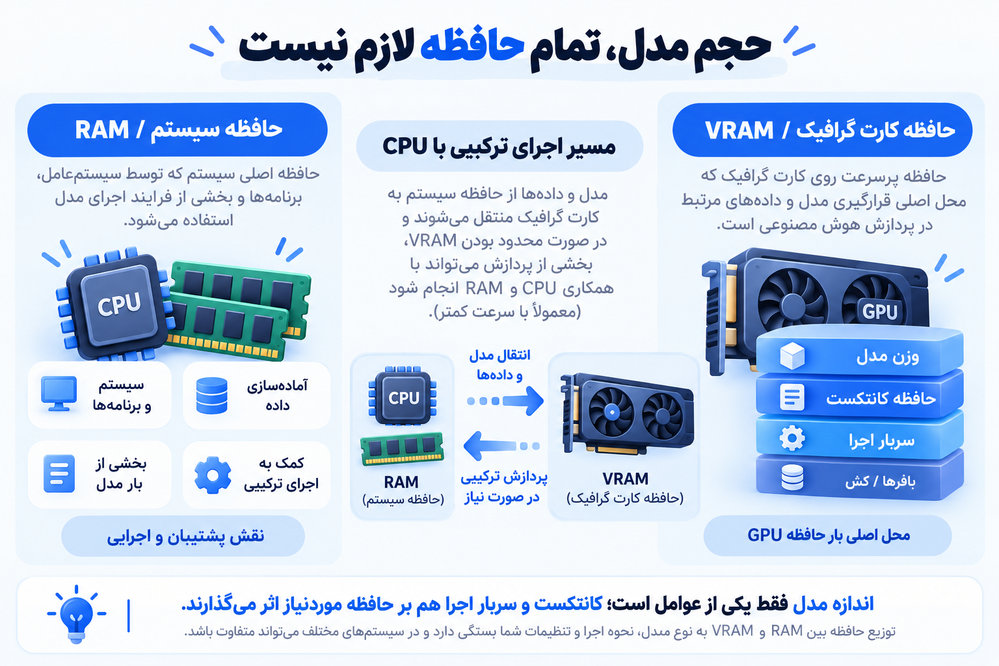
آیا رم سیستم جای VRAM را میگیرد؟
در سیستم دارای کارت گرافیک مجزا، RAM و VRAM دو فضای متفاوتاند. بعضی موتورهای اجرا میتوانند بخشی از مدل را روی CPU و رم قرار دهند؛ llama.cpp از اجرای ترکیبی CPU و GPU پشتیبانی میکند. این قابلیت، رم را از نظر سرعت و رفتار به VRAM تبدیل نمیکند.
آیا دو کارت گرافیک مانند یک کارت با حافظه بیشتر عمل میکنند؟
بعضی ابزارها مدل را بین چند GPU تقسیم میکنند، اما پشتیبانی، ارتباط بین کارتها و نحوه تقسیم کار اهمیت دارد. دو کارت ۱۲ گیگابایتی را بدون بررسی نرمافزار، معادل یک کارت ۲۴ گیگابایتی در نظر نگیرید. توضیحات Ollama نیز تفاوت بارگذاری روی یک کارت و توزیع بین چند کارت را نشان میدهد.
رم، پردازنده و SSD در کامپیوتر مناسب هوش مصنوعی لوکال
چه مقدار رم انتخاب کنیم؟
برای امتحان مدلهای کوچک، ۱۶ گیگابایت میتواند نقطه شروع بررسی باشد. LM Studio نیز برای ویندوز حداقل ۱۶ گیگابایت رم را توصیه میکند؛ این توصیه عمومی نرمافزار است و اجرای تمام مدلها را تضمین نمیکند.
برای خرید سیستم روزمره، پیشنهاد این راهنما ۳۲ گیگابایت رم است تا برای سیستمعامل، مرورگر و برنامههای جانبی هم فضا داشته باشید. اگر مدل بزرگتر، اجرای ترکیبی یا پردازش چند برنامه مدنظر است، ۶۴ گیگابایت را بررسی کنید. ظرفیت مناسب باید پس از مشاهده مصرف واقعی انتخاب شود.
پردازنده چه نقشی دارد؟
در اجرای CPU، توان و پهنای باند حافظه سیستم اهمیت بیشتری پیدا میکند. در اجرای عمدتاً GPU، پردازنده همچنان مسئول آمادهسازی داده و کارهای جانبی است، اما خرید گرانترین CPU لزوماً بهترین تخصیص بودجه نیست.
برای یک دسکتاپ روزمره با محوریت GPU، پردازنده جدید میانرده ۶ یا ۸ هستهای را میتوان نقطه شروع بررسی قرار داد. این پیشنهاد برای اجرای سنگین CPU یا آموزش مدل کافی تلقی نمیشود. پشتیبانی دستورهای لازم ابزار هم مهم است؛ برای نمونه، LM Studio در نسخه x64 ویندوز به AVX2 نیاز دارد. برای آشنایی با وظایف این قطعات، تفاوت CPU و GPU را مطالعه کنید.
ظرفیت SSD را چگونه تعیین کنیم؟
فضای موردنیاز فقط فایل یک مدل نیست؛ نسخههای مختلف، مدل embedding، ابزارها و خروجیها هم جا میگیرند. SSD یکترابایتی برای شروع خرید انتخاب قابلبررسی است و برای نگهداری مدلها و خروجیهای بیشتر، ظرفیت دو ترابایت را بررسی کنید.
SSD سریعتر میتواند زمان بارگذاری را کاهش دهد، اما فضای ذخیرهسازی جای ظرفیت حافظه کاری را نمیگیرد. اگر کار اصلی شما توسعه نرمافزار است، هنگام مقایسه کیس مخصوص برنامه نویسی ظرفیت لازم برای دستیار محلی را نیز جداگانه لحاظ کنید.
پیشنهاد سیستم مناسب AI لوکال در سه سطح
ترکیبهای زیر الگوی برنامهریزی هستند و بنچمارک عملی این مقاله محسوب نمیشوند. فرض مدلهای متنی، نسخه Q4_K_M، یک کاربر و کانتکست حدود ۴ تا ۸ هزار توکن است. سازگاری کارت و مصرف واقعی باید پیش از خرید بررسی شود.
| سطح | پردازنده پیشنهادی برای بررسی | RAM | VRAM پیشنهادی برای بررسی | SSD | نمونه هدف |
|---|---|---|---|---|---|
| شروع و یادگیری | پردازنده جدید ۶ هستهای سازگار | ۱۶ تا ۳۲ گیگابایت | CPU برای مدل کوچک؛ ۸ تا ۱۲ گیگابایت برای بررسی برخی مدلهای 8B | ۵۰۰ گیگابایت تا یک ترابایت | چت سبک و آزمودن مدلهای کوچک |
| استفاده روزمره | پردازنده جدید ۶ یا ۸ هستهای | ۳۲ گیگابایت، با امکان ارتقا | ۱۲ تا ۱۶ گیگابایت | یک ترابایت | Qwen3-8B؛ بررسی Qwen3-14B روی ظرفیت بالاتر |
| مدلهای بزرگتر | پردازنده متناسب با پردازش جانبی و پلتفرم | ۶۴ گیگابایت یا بیشتر | ۲۴ تا ۳۲ گیگابایت یا بیشتر پس از محاسبه | دو ترابایت | بررسی Qwen3-32B با کوانتایز ۴ بیت |
برای نمونه، فایل حدود ۱۹٫۸ گیگابایتی Qwen3-32B Q4_K_M به حافظه کانتکست و سربار اجرا نیز نیاز دارد. بنابراین، کارت ۲۴ گیگابایتی نباید بهعنوان تضمین اجرای همه تنظیمات آن معرفی شود.
برای انتخاب سایر قطعات و بررسی تعادل سیستم، راهنمای کیس مناسب برای هوش مصنوعی و یادگیری ماشین مکمل این پیشنهادهاست.
سیستم تولید تصویر و ویدئو را جدا انتخاب کنید
در تولید تصویر، نام دقیق مدل، رزولوشن، batch و افزونههایی مانند کنترلهای اضافی را ثبت کنید. برای نمونه، ارزیابی یک گردش کار SDXL با آزمون یک مدل FLUX یا ویدئویی یکسان نیست. اگر هم طراحی انجام میدهید و هم تصویر تولید میکنید، در انتخاب کیس طراحی نیاز نرمافزار طراحی و مدل مولد را همزمان بررسی کنید.
روشهایی مانند offloading، slicing و tiling میتوانند در گردشهای کاری پشتیبانیشده مصرف حافظه را کاهش دهند، اما محدودیت و هزینه عملکردی دارند. مستندات Diffusers تأکید میکند که روش مناسب به مدل و نحوه اجرا بستگی دارد.
پاور، خنککننده و بدنه کیس چقدر مهماند؟
پاور را بر اساس مدل دقیق GPU، پردازنده، توصیه سازنده، اتصالات لازم و کیفیت خود منبع تغذیه انتخاب کنید. یک عدد ثابت برای همه سیستمهای AI معتبر نیست. راهنمای پاور مناسب کیس هوش مصنوعی به بررسی این بخش کمک میکند.
برای بدنه نیز طول و ضخامت کارت، فضای نصب خنککننده، مسیر ورود و خروج هوا و امکان سرویس را بررسی کنید. پایداری در پردازش طولانی اهمیت بیشتری از نورپردازی دارد. همچنین فرق کیس هوش مصنوعی و کیس معمولی را باید در تناسب قطعات با کاربرد جستوجو کرد؛ ظاهر بدنه بهتنهایی معیار نیست.
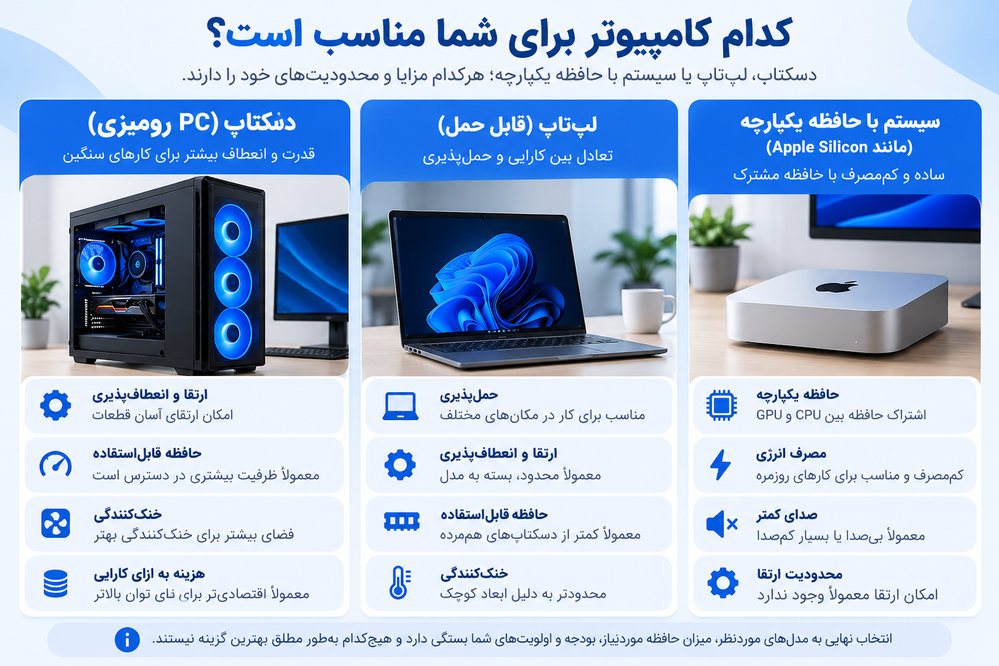
دسکتاپ، لپتاپ، مک یا مینیپیسی؟
اگر جابهجایی نیاز اصلی نیست، دسکتاپ معمولاً مسیر بازتری برای تعویض قطعات و توسعه دارد. در لپتاپ، ظرفیت واقعی VRAM، محدودیت توان GPU، خنککنندگی و امکان ارتقای رم را بررسی کنید. نام مشابه گرافیک لپتاپ و دسکتاپ، به معنی عملکرد برابر نیست. برای بررسی این موارد، ویژگی های لپ تاپ هوش مصنوعی را در کنار نیاز مدل بخوانید.
در مکهای Apple Silicon و بعضی سیستمهای دیگر، حافظه یکپارچه میان بخشهای مختلف مشترک است؛ کل ظرفیت نصبشده را حافظه آزاد و اختصاصی مدل فرض نکنید. مقدار قابلاستفاده، پهنای باند و پشتیبانی ابزار باید بررسی شود.
آیا داشتن NPU برای AI لوکال کافی است؟
NPU در برنامههای سازگار میتواند برای پردازش محلی با مصرف انرژی مناسب مفید باشد، اما مدل و موتور اجرا باید از آن پشتیبانی کنند. مستندات Windows ML نیز شتابدهی را از مسیر ارائهدهندگان اجرای سازگار با CPU، GPU و NPU توضیح میدهد.
عدد TOPS یا برچسب AI PC بهتنهایی مشخص نمیکند مدل انتخابی شما با چه سرعتی اجرا میشود. برای توضیح بیشتر، مطلب نقش NPU در لپتاپهای هوش مصنوعی را ببینید.
چگونه توان سیستم فعلی را برای اجرای AI بررسی کنیم؟
پیش از خرید سیستم مناسب ai لوکال، مدل CPU، مقدار رم، نام دقیق GPU، حافظه اختصاصی آن و فضای SSD را یادداشت کنید. در ویندوز، بخش Performance در Task Manager نقطه شروع مناسبی است؛ Shared GPU Memory را با VRAM اختصاصی یکسان در نظر نگیرید. برای راهنمای عملی، مشاهده مشخصات کامپیوتر در ویندوز را دنبال کنید.
سپس یک مدل کوچک و معتبر را در نرمافزار سازگار امتحان کنید و این موارد را ثبت کنید:
- نام و نسخه مدل، کوانتایز، موتور اجرا و طول کانتکست.
- زمان بارگذاری سرد مدل و زمان شروع اولین پاسخ.
- سرعت تولید خروجی پس از شروع پاسخ و میزان مصرف RAM و VRAM.
- کیفیت پاسخ در کار واقعی شما، بهویژه زبان فارسی یا کدنویسی.
- تغییر سرعت و دما در چند اجرای متوالی.
در Ollama، دستور ollama ps میتواند وضعیت بارگذاری مدل و سهم CPU/GPU را نشان دهد. سرعت توکنبرثانیه را فقط با شرایط همسان مقایسه کنید؛ توکن با کلمه یکسان نیست و سرعت ثبتشده روی یک متن انگلیسی را نباید مستقیم به متن فارسی تعمیم داد.
اگر سیستم ضعیف باشد، چه چیزی را تغییر دهیم؟
ارتقا را از گلوگاه شروع کنید. اگر حافظه GPU پر میشود، اول مدل کوچکتر، کوانتایز مناسب و کانتکست کوتاهتر را امتحان کنید. اگر رم سیستم پر است و جابهجایی مداوم با دیسک رخ میدهد، افزایش رم میتواند مؤثرتر باشد. اگر فقط شروع کار کند است، وضعیت SSD و بارگذاری مدل را بررسی کنید.
برای تصویر و ویدئو نیز رزولوشن، تعداد خروجی همزمان و مراحل گردش کار را کاهش دهید. در روشهای offloading، بخشی از اجزا به CPU منتقل میشوند؛ بهخصوص انتقال ریزدانه و مکرر میتواند سرعت را بهشدت کاهش دهد.
قبل از ارتقای GPU، فضای بدنه، توان و اتصالات پاور و سازگاری نرمافزار را هم کنترل کنید. هنگام مقایسه قیمت کیس کامپیوتر کامل، هزینه سیستم آماده را با مجموع ارتقای قطعات فعلی بسنجید؛ ظرفیت حافظه، کیفیت پاور و مسیر توسعه را نیز در این مقایسه لحاظ کنید.
اجرای محلی بهتر است یا سرویس ابری؟
برای استفاده مداوم از مدلی که روی سختافزار شما عملکرد مناسبی دارد، اجرای محلی میتواند کنترل بیشتری بر داده و هزینه جاری ایجاد کند. برای استفاده پراکنده از مدل بسیار سنگین، خرید سختافزار ممکن است توجیه کمتری داشته باشد. هزینه API یا اجاره GPU را با هزینه خرید، برق، استهلاک و زمان نگهداری مقایسه کنید.
خصوصیبودن هم به کل مسیر پردازش وابسته است. اجرای مدل محلی، اتصال افزونه جستوجوی وب یا استفاده از API بیرونی را محلی نمیکند. برای اسناد حساس، محل اجرای مدل و embedding، ذخیره گزارشها و دسترسی شبکه را بررسی کنید. مجوز استفاده تجاری هر مدل نیز باید جداگانه خوانده شود.
چکلیست نهایی انتخاب سیستم مورد نیاز هوش مصنوعی لوکال
برای انتخاب سیستم مناسب اجرای هوش مصنوعی لوکال، این شش مورد را پیش از سفارش مشخص کنید:
- کاربرد: متن، کدنویسی، اسناد، تصویر، صوت یا ویدئو.
- مدل هدف: نام دقیق، کوانتایز و کانتکست موردنیاز.
- سازگاری: ابزار، سیستمعامل، GPU و درایور.
- عملکرد: کیفیت پاسخ، زمان انتظار و تعداد کاربران همزمان.
- تعادل قطعات: RAM، VRAM، SSD، پاور و خنککنندگی.
- هزینه و ارتقا: ارزش خرید سیستم جدید در برابر ارتقای کامپیوتر فعلی.
اگر هنوز مدل هدف را نمیشناسید، با مدل کوچکتر روی دستگاه فعلی شروع کنید. نتیجه همین آزمون، مبنای دقیقتری برای انتخاب کامپیوتر مناسب هوش مصنوعی لوکال خواهد بود.
سوالات متداول
آیا اجرای هوش مصنوعی لوکال بدون کارت گرافیک مجزا امکانپذیر است؟
بله، برخی مدلهای کوچک با موتور اجرای سازگار روی CPU اجرا میشوند؛ اما سرعت و مصرف رم باید با مدل و کاربرد واقعی بررسی شود.
برای شروع اجرای مدلهای زبانی چقدر رم لازم است؟
برای بعضی مدلهای کوچک، ۱۶ گیگابایت نقطه شروع قابلبررسی است. برای خرید سیستم روزمره، ۳۲ گیگابایت انعطاف بیشتری دارد؛ مدل و کانتکست بزرگتر ممکن است حافظه بیشتری بخواهند.
برای AI لوکال کارت گرافیک ۸ گیگابایتی کافی است؟
برای بعضی مدلهای متنی کوانتایزشده و تنظیمات محدود قابل استفاده است؛ اما برای همه مدلها، کانتکستهای طولانی یا گردشهای کاری تصویری کافی نیست.
آیا رم بیشتر میتواند جای حافظه کارت گرافیک را بگیرد؟
برخی ابزارها از اجرای ترکیبی CPU و GPU استفاده میکنند، اما رم سیستم از نظر سرعت و نحوه دسترسی معادل VRAM کارت مجزا نیست.
چرا حجم مدل از حافظه کارت گرافیک کمتر است اما مدل جا نمیشود؟
علاوه بر وزنهای مدل، حافظه کانتکست، بافرهای محاسباتی، سربار موتور اجرا و مصرف سایر برنامهها هم باید در نظر گرفته شود.
آیا سیستم گیمینگ برای اجرای هوش مصنوعی مناسب است؟
ممکن است مناسب باشد، اما باید ظرفیت VRAM، رم، سازگاری ابزار و پایداری زیر بار بررسی شود. عملکرد خوب در بازی بهتنهایی معیار کافی نیست.
آیا لپتاپ دارای NPU همه مدلهای AI را اجرا میکند؟
خیر. استفاده از NPU به پشتیبانی مدل، فرمت و موتور اجرا وابسته است و وجود این قطعه اجرای همه مدلها را تضمین نمیکند.
آیا پس از دانلود مدل میتوان بدون اینترنت کار کرد؟
اگر مدل، موتور اجرا و اجزای لازم محلی باشند، بسیاری از کارها آفلاین انجام میشوند. جستوجوی وب، API بیرونی و دانلود مدل جدید به اتصال نیاز دارند.
برای ارتقای سیستم ابتدا رم را افزایش دهیم یا کارت گرافیک را عوض کنیم؟
ابتدا مصرف منابع را بررسی کنید. کمبود VRAM، پرشدن رم و کندی بارگذاری گلوگاههای متفاوتی هستند و راهحل یکسان ندارند.
آیا مشخصات اجرای مدل برای فاینتیون همان مدل کافی است؟
الزاماً خیر. فاینتیون به روش آموزش، دقت، طول ورودی و تنظیمات دیگری وابسته است و باید جداگانه محاسبه شود.